三周、二十轮训练、600 美元:
我做了一个拿不准就先问的本地 Computer Use Agent
我训了一个 Jev 式的小决策模型,在 Mac 本地运行,让它来操作电脑
gxcsoccer·2026 年 10 月 4 日·约 7 分钟
TypeSafe 的决策模型 Jev 发布的第二天,我开了个新仓库,想验证一件事:一个小到能在 Mac 上跑的模型,能不能也像 Jev 那样一步一步做决定,然后真的去操作我的电脑。
三周过去,算上早几天开始做的视觉模型,一共训了二十来轮,花了大约 600 美元。结论是能做到一部分。不过有一件事,它比我用过的大多数 agent 都做得好:拿不准的时候,它会先停下来问我。
比如演示里的这个任务:从一个文本文件里找出 Lisa Wong 的订单,填进表格。可文件里 Lisa Wong 有两笔订单。大多数 agent 会随手挑一笔填进去,然后告诉你“完成了”。DeskMind 停了下来,问我要的是哪一笔。
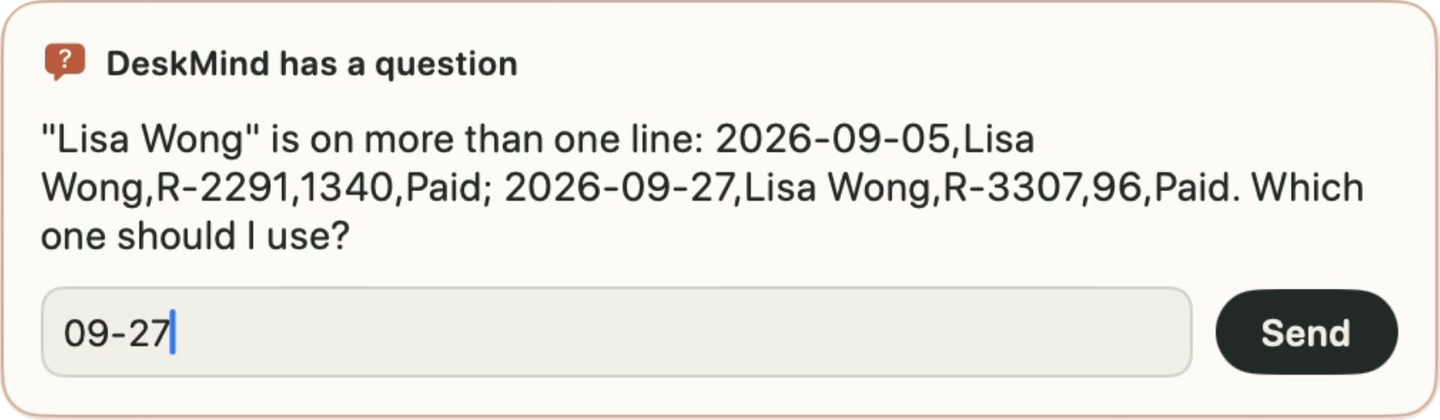
DeskMind 是一个开源的 Computer Use Agent,每一步做决定的模型都跑在你自己的 Mac 上。
演示视频(56 秒) · 下载 Mac 版 · GitHub
这篇写的是我怎么把它做出来,以及路上踩的坑。如果你也在做 agent,最值得看的可能是这三条:想让模型学会问,得先让 harness 给它“问用户”这个选项;“完成”要靠检查结果,不能靠模型自己说;我把训练标签平滑到 0.95,0.8B 的把握就全挤到了门槛边上,七成步骤只好交给慢的 4B。
为什么要放在本地
我现在用 Computer Use 挺多的。用得越多,有三件事就越让我难受。
每一步都要把屏幕截图发到别人的服务器上。邮件、文件,屏幕上开着什么就发什么。
贵。一个任务几十步,每一步都要把屏幕和历史重新发一遍。只是点个按钮,token 却烧得飞快。
慢。最好的模型经常排队,每一步都要来回一趟,一分钟的事能拖到五分钟。
所以我想试试:如果把模型外面那层代码,也就是 harness,专门为一个小模型来设计,它在本地能做多少?大概做不了全部。但只要大多数步骤在本地搞定,难的再交给大模型,隐私、成本和速度就能一起解决。
先做眼睛,再做大脑
我是从“看”开始的。很多应用不提供 accessibility tree(系统给读屏软件用的界面结构),agent 只能在像素里找按钮。于是有了 Eyes,一个 4B 的视觉定位模型。这也是我第一次做模型后训练,先 SFT,再 RL。训练平台前后换了三个,基本是跟着钱走的:Tinker 最省事,也最贵;阿里云 PAI 便宜一些;最后干脆按小时租显卡,最划算。
然后 Jev 横空出世,决策模型一下子火了。我第一眼就觉得这个思路对:别让聊天模型写出下一步要做什么,而是问它一道选择题,读出每个选项的概率。快,不用解析,概率低的时候还能看出它在犹豫。
问题是它只有云端接口,而我不想在一个本地 agent 的正中间放一个云端依赖。那就自己训一个。这就是 Brain:Qwen3.5 的 0.8B 和 4B 加 LoRA,在 Apple 芯片上用 8 位 MLX 跑,接口和 Jev 一样,都是 /v1/systemone。
围着它们的,还有 Hands(macOS 上的 harness)、把一切装在一起的 Mac App,以及我用来测它的一组真实桌面任务 Bench。这五个组件全部开源。
没想到的收获
以前做 agent,活儿都一样:围着一个改不了的模型写 harness。模型在某件事上总犯同一种错,你能做的只有改提示词、加重试。
模型和 harness 都在自己手里,就不一样了。模型可以照着 harness 的需要去训,harness 也可以替模型兜住它不擅长的地方。
还是拿 Lisa Wong 说。harness 发现有两行都匹配,就在选项里加上“问用户”;模型也专门训过,这种时候就选它。少了哪一边都做不成。
再说提前收工,这是大多数 agent 翻车的地方。模型说“完成”,harness 先去看一眼文件到底对不对,再决定信不信。模型自己也拿几乎一样的成对样本训过,比如保存了和没保存、最后一行缺了,所以它本来就很少乱说“完成”。
还有一次,我让它播放一首歌的现场版,它总是点开录音室版。我用成对的数据去训:同一个界面,只差标题里那个“(Live)”。一轮就好了。
模型塑造 harness,harness 反过来塑造模型。做到最后,这个循环成了我在这个项目里最在意的东西。
它怎么决定下一步
harness 会把每一步拆成几道带类型的题:做什么操作、点哪个元素、填什么值。Brain 一次前向计算,读出各个选项字母的 logits,给每个选项一个概率。它从不自己写文字。
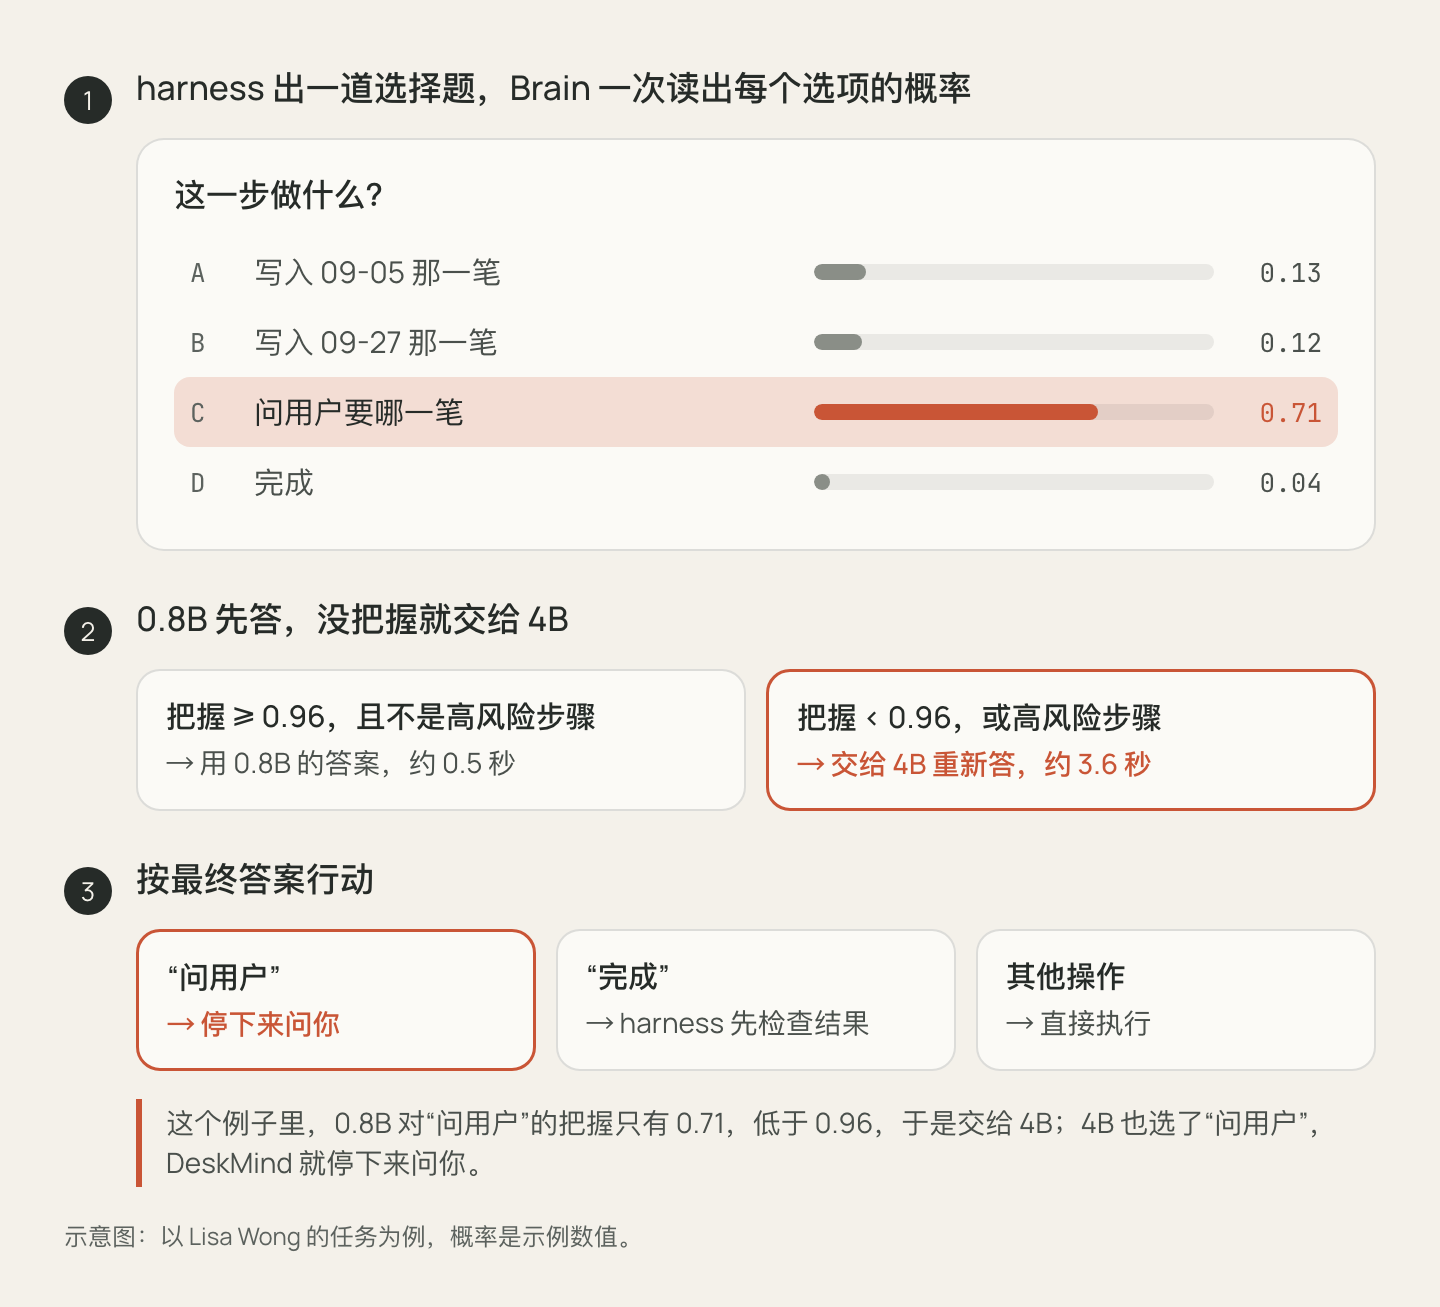
这些概率决定接下来怎么走。0.8B 先答,把握低于 0.96、或者这一步风险大,就交给 4B 重新答。harness 发现两个选项都说得通时,会在选项里加上“问用户”;最终答案是它,就停下来问你。最终答案是“完成”,要等 harness 检查过最终状态才算数。
它也不是万能的。选择题只是消灭了格式错误,判断错误一样会有。正确答案不在选项里,它照样会选一个。
做成了吗
做成了一部分。
隐私:做到了。决策都在你的 Mac 上跑,模型服务只监听本机。App 只在下载模型的时候联一次网。
成本:每一步都是零。钱花在了训练上,三周里租显卡、调训练 API、做标注,一共大约 600 美元。
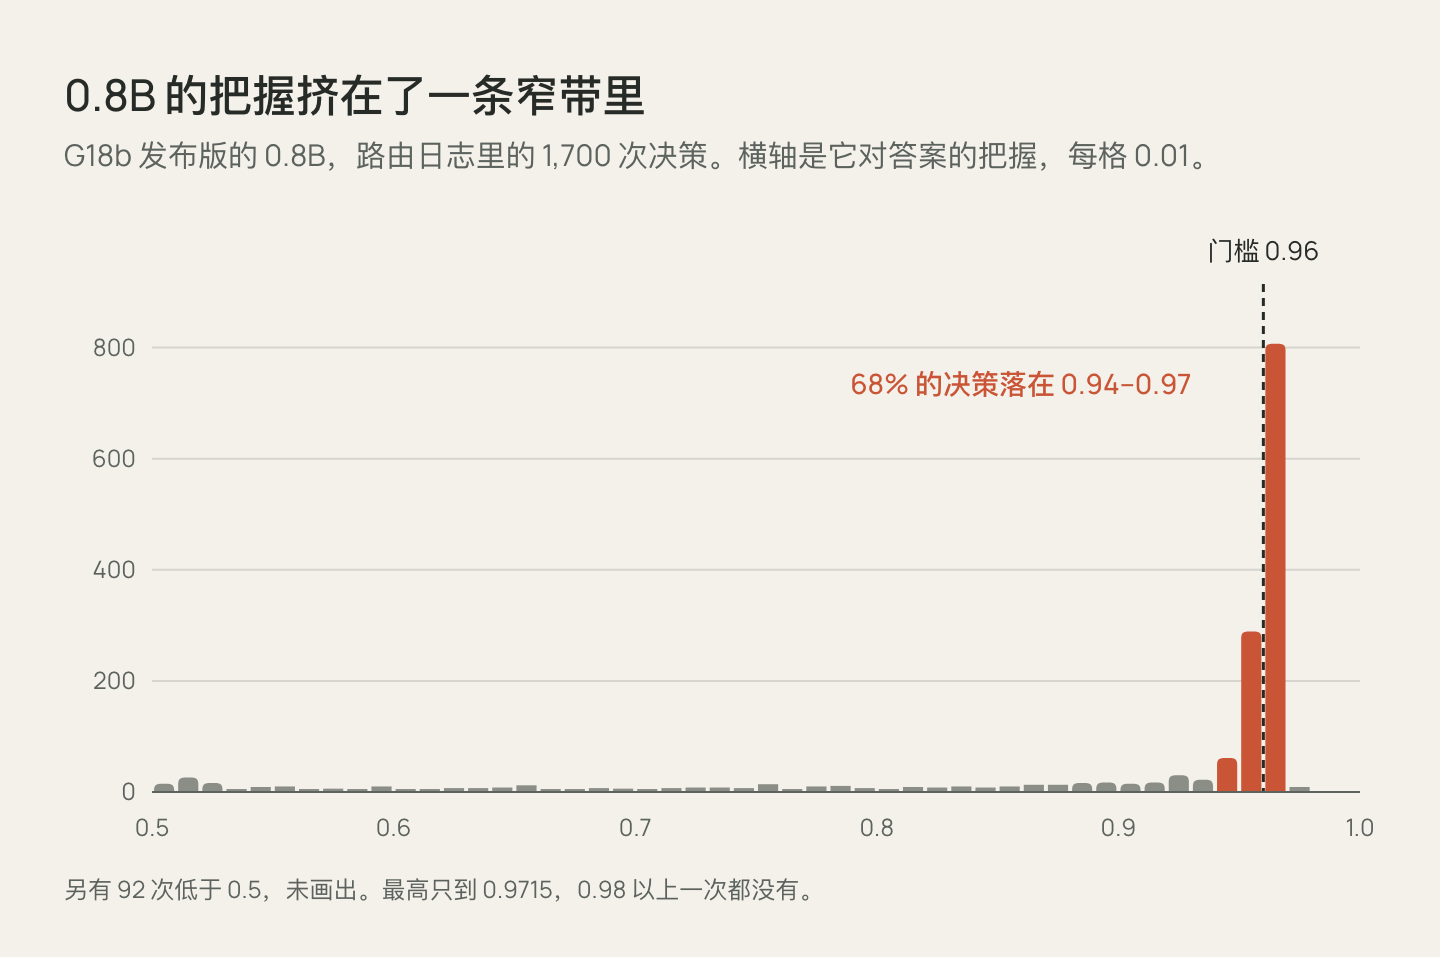
速度:还没有。0.8B 有把握的时候,一次决策 0.5 秒左右。但这一版大约 70% 的步骤要交给 4B,每次 3.6 秒左右,所以中位数是 2.85 秒,最慢的 5% 将近 10 秒。这是我训练时埋下的坑,后面会讲。
混合方案:做了一半。0.8B → 4B 的路由是本地这一半;把最难的步骤交给云端模型,已经设计好了,但 App 里还没有。
成绩和它们的前提:
| 结果 | 范围 | |
|---|---|---|
| 真实桌面(bench v25) | 39/39 结果正确,0 次没做完就说完成 | 自己出的 13 个任务 × 3 次,一台 M4 Pro,经 App;逐题结果 |
| ScreenSpot-Pro(Eyes) | App 实际设置下 50.9%;GPU、原始分辨率下 67.7% | 差距大部分来自分辨率:同样 300 题,200 万像素 49.3%,400 万像素 59.0% |
| JevBench v1.4.2 公开题 | 4B 0.835(193/231) | 提交记录;密封评测还没出分 |
39/39 听着比实际好。这是我自己出的 13 个任务,在一台机器上跑的。有一个任务(G04)的 3 次运行,模型都把文件写对了,却一直没说“完成”,把 20 步用光了;评分只看结果,所以还是算过。评测和逐题结果都公开了,欢迎自己跑一遍。它现在还搞不定超过四五行的表格,也搞不定照着收据照片填报销单。
二十来轮训练教会我的事
最难的是评测。 几乎每一轮都修好了上一个 bug,又悄悄学会一个新捷径。有一轮修好了顺序问题,转头就在顺序错的时候说“完成”;下一轮修好这个,又把表头给覆盖了。从同一批数据里切出来的留出集,带着同样的捷径,根本抓不住。最后管用的是一道关卡:每次上真机之前,把攒下来的所有失败案例,拿新旧两版各跑一遍。
提示词的形状会泄露答案。 我的“完成”样本比别的样本少几道题,模型就学会了:题少,就是完成。
固定的软标签会把把握压扁。 我拿平滑到 0.95 的标签去训 0.8B,结果它的把握全挤在 0.94 到 0.97 之间,路由分不清哪步简单哪步难。上面那 70% 的升级率就是这么来的。下一轮改成学 4B 预测的概率分布。
“先问”要专门训,还得守住。 有一轮压根没学会问,自信满满地写错了行;后来又有一轮丢了一部分,直到我重新调了门槛。现在“先问”是关卡里单独的一项。
感谢 Claude Code
三周,五个仓库,一个 Mac App,一套评测,二十来轮训练。没有 Claude Code,我一个人做不完。我同时开着好几个会话,一个管模型和训练,一个管 harness、App 和评测,它们在一个私有仓库里用 issue 互相同步,写了大部分代码,跑了训练和真机测试,也帮我挑出了不少错。我做的,是决定做什么、测什么,以及什么时候算可以发布。不管代码是谁写的,每次发布都要先过真机关卡。
试试看
Mac App 需要 macOS 15 以上、Apple 芯片,运行时大约占 7 GB 内存。下载 DMG。第一次运行会下载约 5.3 GB 模型,Hugging Face 慢的话会自动换成 ModelScope。按 ⌘. 停止,动一下鼠标就会暂停。
也可以把 Brain 接进你自己的 agent:
git clone https://github.com/deskmind-ai/brain && cd brainuv sync --extra mlxuvx modelscope download --model gxcsoccer/brain-0.8b --revision g18b-q8 --local-dir models/brain-0.8buvx modelscope download --model gxcsoccer/brain-4b --revision g18b-q8 --local-dir models/brain-4buv run deskmind-brain-serve --predictor mlx:models/brain-0.8b --escalate-to mlx:models/brain-4b --two-stage --port 8796curl -s localhost:8796/v1/systemone -H 'Content-Type: application/json' -d @examples/request.json文档里有一个 30 行的客户端示例。ModelScope 上的模型和 Hugging Face 上 deskmind 组织里的是同一份文件。
接下来要做的:更快的 0.8B、更多应用、一个专门处理“本地不该自己拿主意”的云端层。如果你也围着一个改不了的模型写过 agent,很想听听:两边都握在自己手里,会不会改变你的做法。最简单的参与方式:给它一个有歧义的任务,看它会问还是会猜。猜错了,就把例子发到这条 issue 里;想聊思路,来讨论区。